谁在制造 Anthropic、OpenAI?万份简历支撑的 AI 大浪潮
本文目录
前言
OpenAI、Anthropic 是目前世界顶尖的AI 大模型实验室,经常被和 Google DeepMind 并列称为“御三家”,他们时时刻刻都在影响着整个资本市场资金的流动。
最近一段时间,Anthropic ARR 的增速和市场预期有些差异,很多公司股票上蹿下跳。有人开玩笑说,一个非上市公司的季度数据里短短一行,居然可以对美股半导体板块产生巨大影响,简直无法想象等这些公司上市之后会出现什么幺蛾子。他们估计在今年三四季度有可能上市。即使今年不上,OpenAI 的 CFO 也说了,2027 年肯定会上的。
所以,我想换一个角度来研究这些公司:除了巨大 CapEx、租用或建造了无数像钢铁怪兽一般的数据中心之外,到底是什么样的人,在把我们日常生活中深度依赖的这些前沿大模型做出来的?
为此,我翻了 2 万多份简历。要写在前面的是,这篇文章受到了《晚点》2023 年由汉阳写的关于币安报道的启发,所以文章的很多结构其实参考了当时汉阳的报道。我们也将在网上收集到的 2 万份简历“用铅笔一条条抄在纸上”。请注意,我们收集到的信息未必全部准确,也无法覆盖这些公司的全部情况;更有可能的是,收集到的信息在日新月异的 AI 时代已经过时。
所以你就当作是一个戏说 AI 公司的版本,千万不要信以为真。
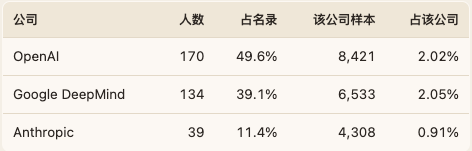
LinkedIn 上官方显示的关联人数是 26,454 人,实际上能够获取到的简历是 19,262 份(Anthropic:4,308 份,OpenAI:8,421 份,DeepMind:6,533 份)。经过进一步数据清洗后,包含可用信息的有 17,214 份。但这些信息并不代表完全更新或完全透明,大量的数据都是缺失或不完整的,得出的所有结论其实都是近似,能做到的也就是“窥一斑”,未必能“知全豹”。
本文分析主要围绕在 Anthropic 和 OpenAI:一方面是因为它们是从 startup 公司起步,具有更强的代表性,外界了解也更少;另一方面也是因为 DeepMind 和谷歌的整体数据清晰度更差。很多时候很多人在简历里会写自己在 Google 工作,而不会写在 DeepMind,导致它的数据可能跟我们一开始预计的并不一样。本文主要讨论的是 Anthropic 和 OpenAI 两家的数据,但是 DeepMind 的数据也会作为参考,帮助大家有一些不同的视角。
这篇文章会聊一下几家前沿 AI 公司的城市分布:城市、国家、学校、人才来源、职能和语言分布,也会专门讨论一下这些公司当中的中国人有多少,以及他们都有什么样的故事。
城市/国家的分布
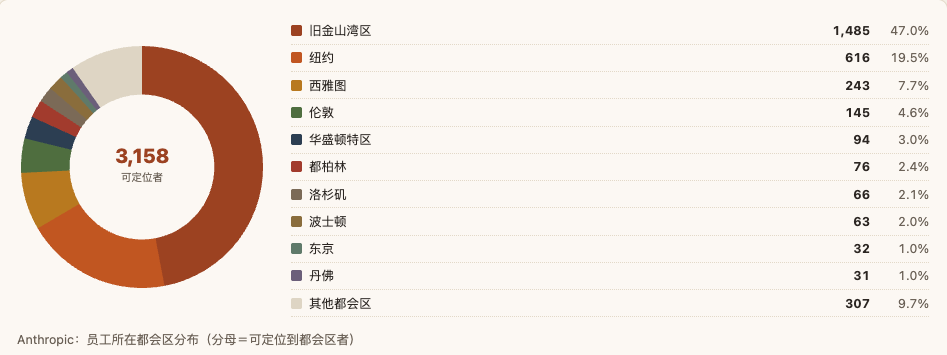
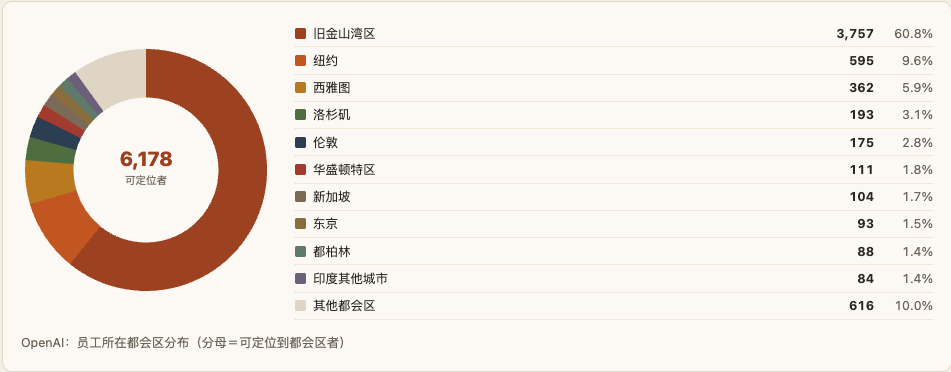
在有提供数据的档案当中,旧金山湾区占了 绝对大多数,比如说Anthropic 占 47%,OpenAI 占 60.8%。
这其实也没什么奇怪的,因为 Anthropic 跟 OpenAI 本来就是在旧金山起家的,非常合情合理。此外,人员还遍布几个美国大城市包括纽约、西雅图、华盛顿、洛杉矶和波士顿。这些基本都是高校、科技公司密集的地方。在美国之外,有人员分布、值得关注的城市主要有三个:
-
伦敦:伦敦 Anthropic 有 145 个员工,OpenAI 有 175 个员工。
-
都柏林:作为欧洲的销售总部或运营中心,Anthropic 有 76 个人,OpenAI 有 88 个人
-
东京/新加坡:Anthropic在东京有 32 个人,但是,OpenAI 在亚洲最大的城市其实是新加坡(有 104 个人),东京有 93 个人。这好像跟我在推特上看到的感受也一样。
其余剩下的那些数据,其实说实话,我个人更倾向于认为,比如这个用户搬去了美国工作,但他 LinkedIn 上可能还写的是德国或法国的原籍,并没有改变 LinkedIn 上的常驻城市。但 anyway,我觉得这个数据还是可以作为一个大概城市和国家分布的参考。
学校的分布
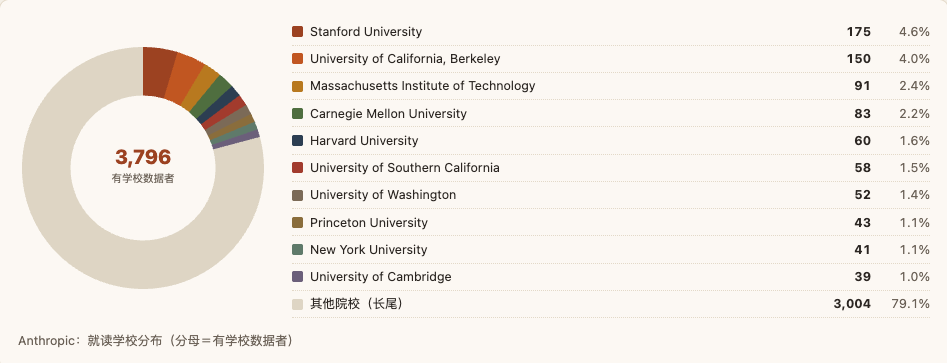
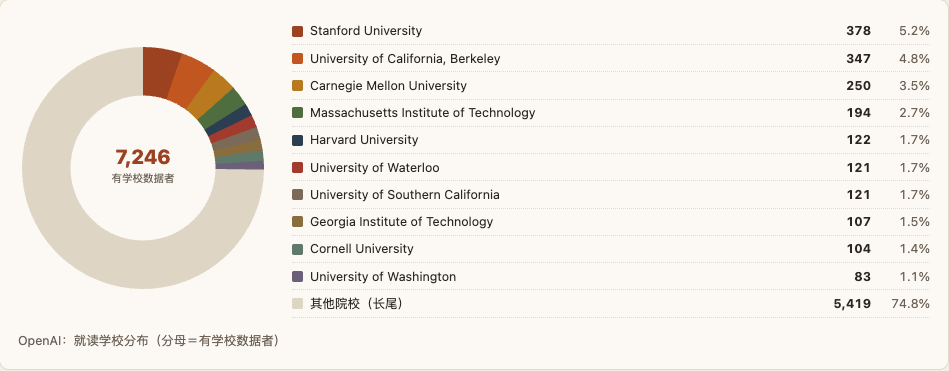
学校的分布就更加长尾了。比如说以Anthropic为例,前 10 所学校的分布加起来才20.9%。当然,你能看到斯坦福大学、伯克利、麻省理工学院(MIT)、卡内基梅隆大学(CMU)和哈佛大学是标准的前 5 所学校,也是标准的 target school,主要是来自这 5 所学校的人贡献了14.7% 的员工。
但同一时间,你能发现学校的分布是非常非常长尾的:前 60 所学校的覆盖人数占了 47.9%,另外一半的人其实分散在另外 1308 所学校里面,很多学校都只有一两个人。
举一个可能相对反常识、超出我预料的例子:西北大学其实只有 13 个人,占比仅为 0.3%。所以它也是属于其他那一大部分长尾学校里的其中一所。
这个学校的分类和我一开始预计的其实是有一定差距的。我本来以为学校的集中度会更高,后来发现也不是所有人都是 researcher,后面我们在职能部分可以再详细讨论。
有意思的是OpenAI 的数据可能会有一些差别,滑铁卢大学在这里排进了第六名,比我想的要高。其他的数据分布和 Anthropic 类似的。还有另外一个有意思的事情:在 OpenAI 这一边,有 23 个人是来自清华大学,占比是 0.3%。这其实比很多美国本地的学校都要高一些,是唯一能排到前面的外国大学。
写到这里,我知道有一些黑粉要说了:“你看一下 OpenAI 的团建合影,就会发现都是清华北大的呀,美国前沿实验室也都是中国人做的,怎么只有 23 个人来自清华呢?” 我觉得你说得对。可问题就在这里:在 LinkedIn 上,复查时发现,很多我确切知道是清华大学毕业的人,并没有在 LinkedIn 上填第一学历,可能只写了在伯克利或者是斯坦福读的硕士或博士。这样一来,数据上就显示他们不是来自清华。虽然我本人知道他们是清华的,但这在统计上没办法一一列举,所以这里只能看个大概。
前雇主的分布
以 Anthropic 为例吧,4000 多份简历当中,标明雇主的有 2700 多份(因为有 1000 多份简历本人没有填写,或者信息被平台遮蔽了,所以看不到)。
另外的部分当中,有一些在前 40 名雇主,有一些不在前 40 名雇主。所以你可以想象,前 40 名雇主就是科技行业大厂的排行榜。
Anthropic员工的前雇主分布
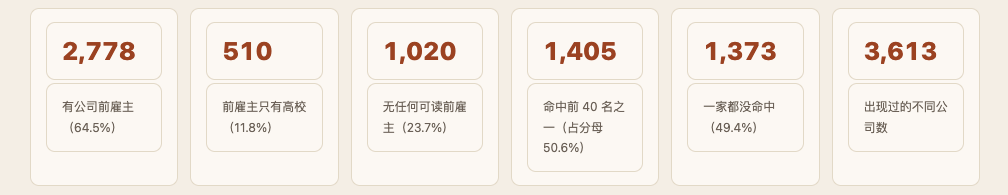
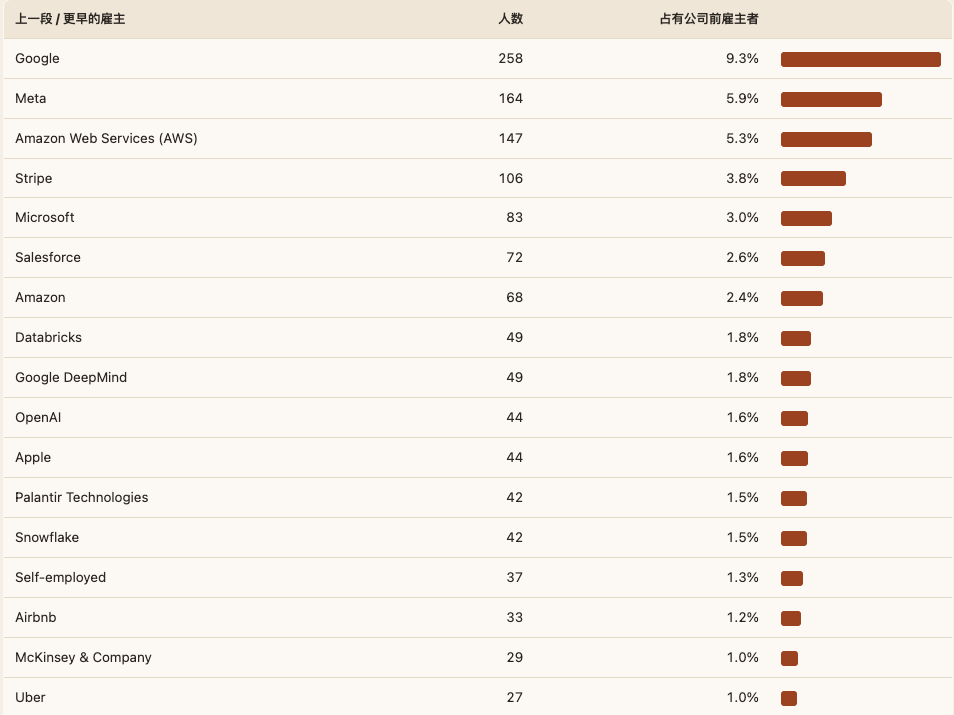
而在明确标注前一任雇主的有效样本当中,人才来源排名前三的公司分别是 Google、Meta 和 AWS。
这里要注意一件很有意思的事情:亚马逊云和亚马逊在 LinkedIn 上其实被分为两家公司,很多员工也会在 LinkedIn 上非常清楚地标注自己是 work for AWS 而不是 Amazon。这可能跟亚马逊本身的员工数量非常庞大、一部分人希望更明确地标注自己的业务板块有关系。
除此以外,从创业公司跳槽到 Anthropic 最多的贡献者其实是 Stripe,有 106 人,占了有数据的总样本 3.8%,都可以拉个大校友群了。貌似这是因为 Anthropic 的 co-founder Daniela 之前在 Stripe 有很长的职业经历。
Anthropic员工的前雇主分布
这个统计的分布结果和 OpenAI 的结果其实是非常类似的。OpenAI 也是有 5028 个有前雇主或者明确应届毕业生身份这样的档案列表。但是前三名的雇主是 Meta、Google 和 Apple,前五名的雇主是 Meta、Google、Apple、AWS 和 Microsoft。其中有一个创业公司贡献最多,其实是 Statsig,是因为 OpenAI 之前收购了这家公司,所以 129 个员工直接打包进厂。
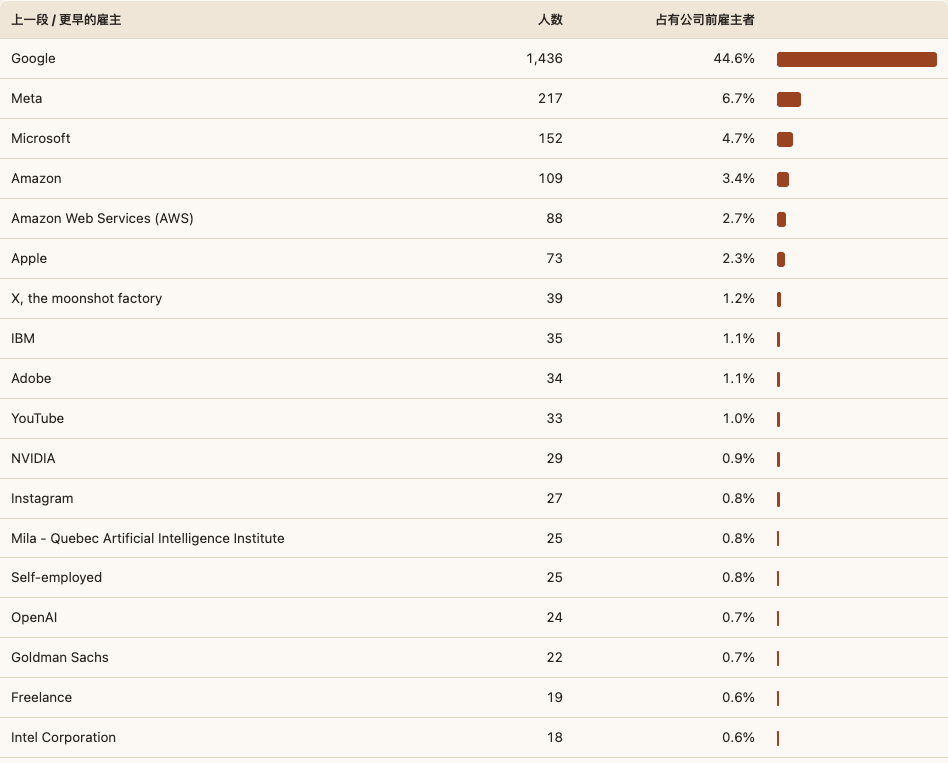
这里分支出来看看DeepMind:数据其实从大的分布上差不太多,但他们的上一个雇主来源会有一些差别。第一名当然就是 Google,占了样本总量的 44.6%。其中还有一个很值得注意的是,有 39 个同学来自Google X,占了 1.2%;甚至来自 Windsurf 的同学有 16 个,但这 16 个还不如高盛的 22 个。
Deepmind员工的前雇主分布
但是这个问题你反过来想:在 OpenAI 的员工当中,上一份工作在Google待过 的有 426 个人;在 Anthropic 这边,上一份工作是 Google 的也有 258 个人,所以基本上有 600 多号人来自 Google。所以确实,谷歌体系是两家最大的人才输出地。在谷歌工作,看到自己的同事不断地离职、去到新的 startup 公司,也是会有一些 peer pressure 的。
实验室的人才竞争
我知道你们想问什么,你们想了解的事情是:
-
Anthropic 多少人去了 OpenAI?是谁?
-
OpenAI 多少人去了 DeepMind?是谁?
-
DeepMind 多少人去了 Anthropic?是谁?
在这个人才三角战争当中,我感觉我得到的数据并不置信。样本量太小,而且复查之后觉得有瑕疵,所以就不在这里造谣了。但如果你很有兴趣,可以留言,我可以认真一个一个看。
第二梯队的实验室会往前三家跑,这里记录的,其实是前三家的实验室从第二梯队实验室吸收的人才数量。
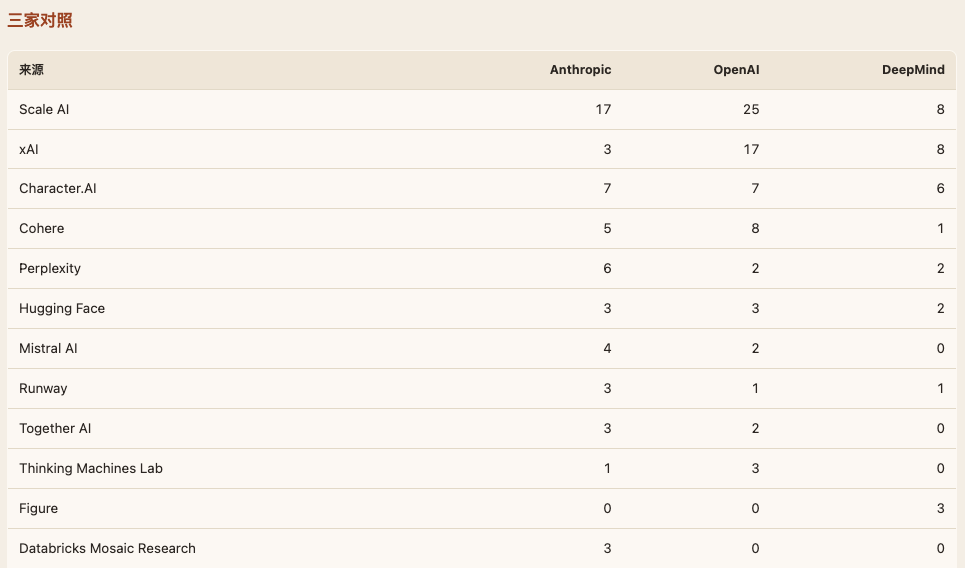
职能的分布
这些人具体是做啥?我做了一些职能分类,因为 LinkedIn数据非常奇怪,甚至会把“创业”都写成职能分类,这显然是不合理的。我的处理方法是:把每个人的档案标题、个人描述以及公司职位拼成一段文本,按关键词规则进行互斥归类,命中即停止,优先级从研究工作一直覆盖到数据工作。样本数据情况如下:4,000 多人中,约 70%(即 3,000 人)存在可分析的有效样本,其中有 1,890 人可以被明确正经归类,占了全部简历的一半左右。
因此我认为这个结果具有一定的代表性,可以分享。
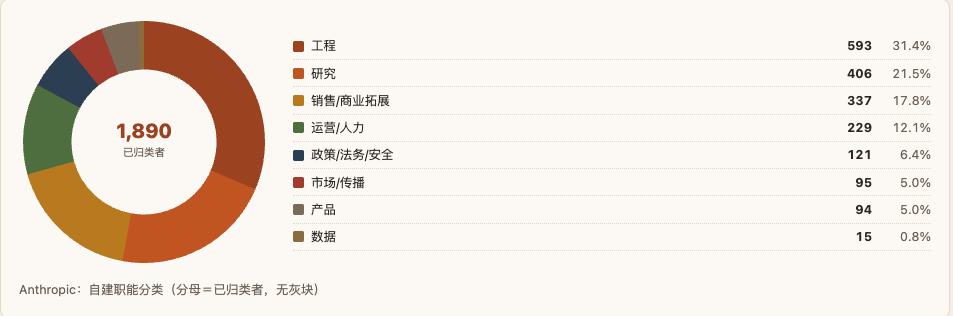
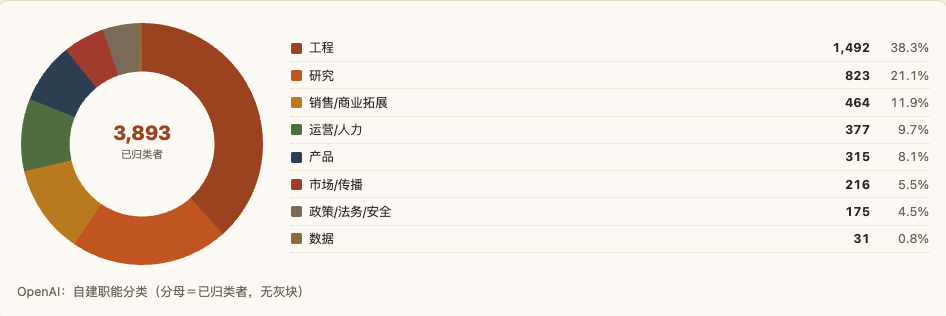
在同一个口径之下,我们会发现 OpenAI 和 Anthropic 有一些细微差别,主要体现在:
-
工程比例:OpenAI 的工程人员比例相对更高
-
销售比例:OpenAI 的销售人员比例其实并没有 Anthropic 高。
-
政策、法务与安全:从绝对人数上来说是 OpenAI 更高,但从比例上来说,Anthropic 要高出很多。
这里要说明一点:如果一个人的 title 是 Member of Technical Staff,在我的定义当中,其实会被放进“研究”而不是“工程”。我理解这个定义是有一些偏颇的,但实在是无法对这个人到底做研究还是做工程,给出一个非常清晰的定义。我甚至觉得这个公司也无法做出定义,所以我就做了这样一个主观判断。
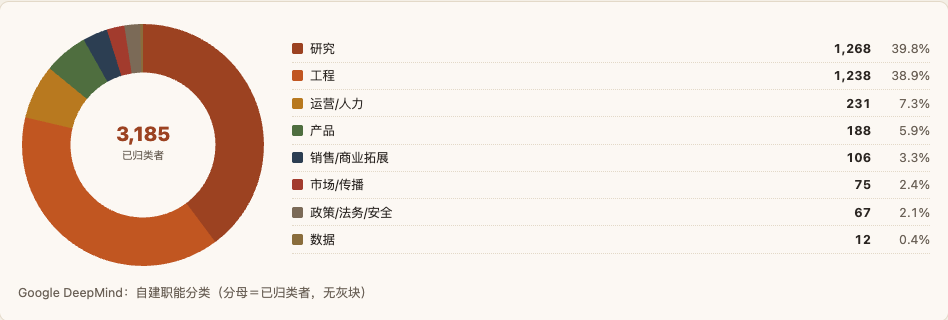
如果你去看 Google DeepMind 的职能分类,就会发现他们的研究和工程人员比例远远超过 Anthropic 和 OpenAI。其他职能的人员绝对人数不一定少,但相对来说比例要低得多。我怀疑这可能是因为很多职能(包括销售、产品、法务、数据等)已经被母公司 Google 承担了一部分,所以这个 Headcount 的分类可能不太一样。
请注意,我们在数据整理上已经做了尽可能多的处理和清洗。因为在个人经历当中有非常多可以造假的地方,比如很多在校学生会显示自己是 OpenAI 的校园大使,有些自媒体可能只接过一次商务单,就在 LinkedIn 上写自己是 Anthropic 的 Content Creator 之类的。针对这类不太靠谱的情况,我们会尽力去处理和鉴别,但肯定无法做到 100% 准确。因此我们主要从宏观分布上去看整体趋势,在具体的微观细节上不能保证准确。
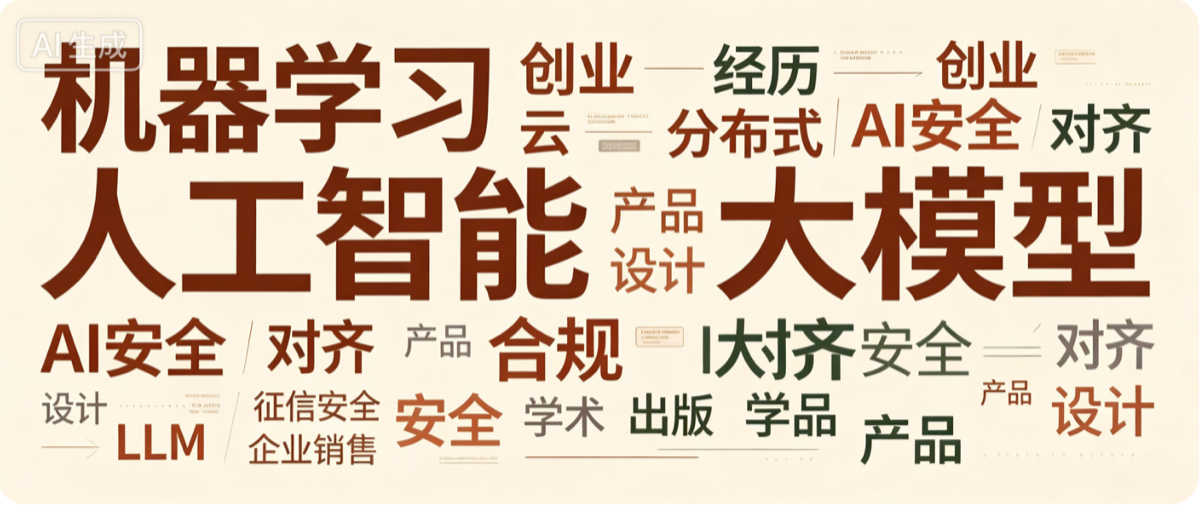
另外得到的一个副产品是:如果我们不把人当作一个部门来单独看并进行分类,只是把他的技能作为一个关键词进行扫描,做一个词云的话,你就会发现里面非常常用的一些高频关键词:
说什么语言?
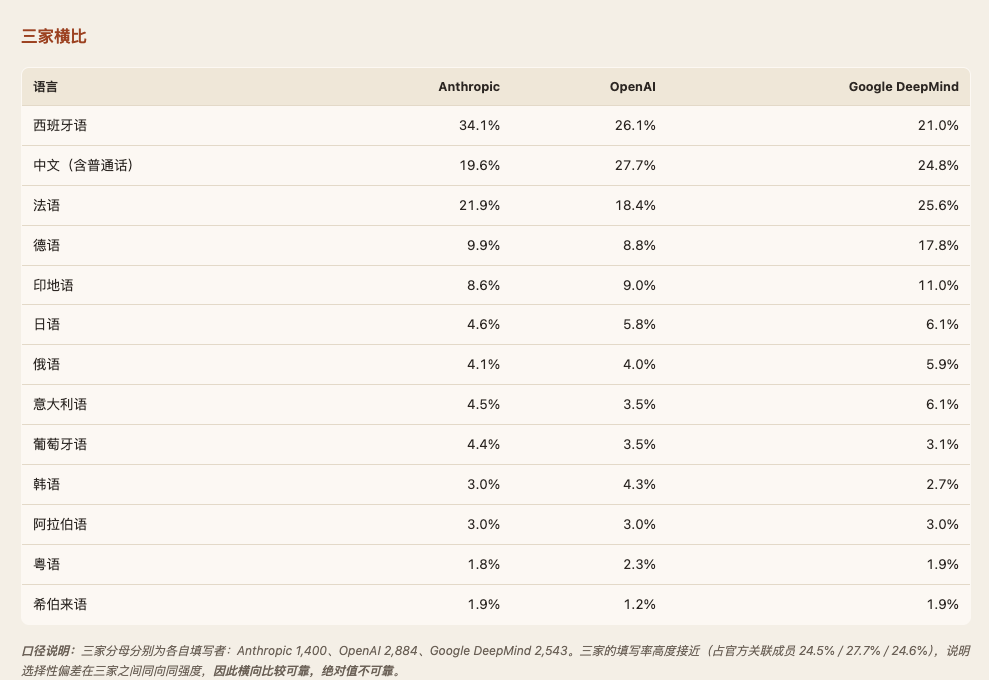
LinkedIn 上很多人会标注自己会说的语言,但大家肯定都不会标注英文,因为英文应该是默认大家都会说的语言。
在美国读书的人当中,西班牙语和法语肯定是最重要的二外(一外?)。但中文的话在这里占了平均20%多,我认为这基本上也蛮符合很多华裔在这些公司工作的情况。
中国人有多少
之前社交媒体上经常讨论,中美大模型的竞争其实就是在美国的中国人和在中国的中国人之间的竞争。这件事情是不是真的,我们不能确定,但是可以从一些数据上看出一些端倪。这也就是一开始我希望通过这个数据分析,能抓到的一些有意思的结论或者观察。
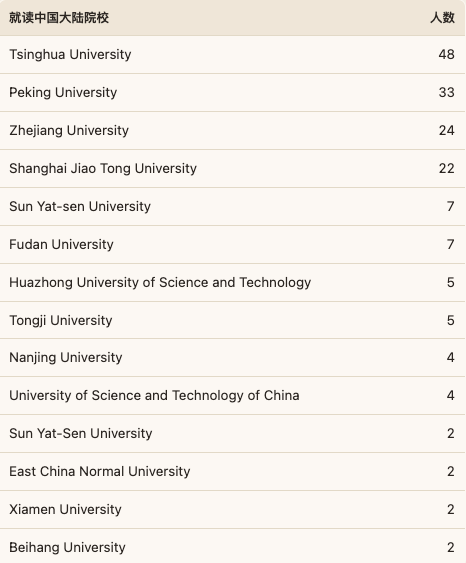
首先,我们来看的是,在这 2 万份简历当中,到底有哪些人是有明确的中国背景的。中国背景定义为:他之前在中国的大学读过书,或者在明确的中国公司上过班。在中国的大学读过书:比如说北大、清华。在中国的公司上过班:比如说阿里、腾讯。这里还要去掉一些不远万里来中国学中文的美国人,或者是在泰国的腾讯工作的新加坡人。去掉这些之后,剩下的人总共样本是 343 个。
这些人是正儿八经、根正苗红的中国人。所以在这里,你会发现他们读书的学校主要来自清北浙交(不是复交,是清北浙交),然后他们在中国公司的工作经历主要是在 BAT 和华为(这里的 B 指的是 ByteDance)
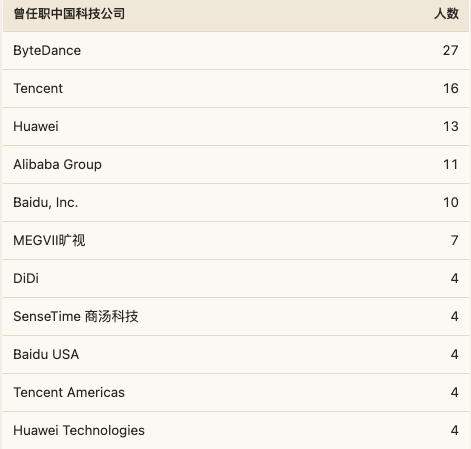
非常明确地告诉你,在这 343 个里面,不包括在百度工作的 Dario。这个名字我单独拿出来了,就不在里面哈!
如果你细看这些档案的话,很多人是在国内读了本科之后,出国读了硕士或博士。主要的学校包括:伯克利,卡耐基梅隆,斯坦福大学,USC,UCLA。他们也同时在很多国外的顶尖公司工作过,其中包括 Google、微软、Meta、亚马逊和英伟达。然后在最近的两三年内,在不同的时间加入了御三家。
到底中国人有多少?
到这里,你一定会觉得这个数据可能跟你想的太不一样。因为你明明在那么多视频、那么多播客当中看到过那么多的中国人,他们的名字都是汉语拼音,看起来至少也大概率是个 ABC,怎么最后占公司的比例只有不到 2% 呢?
这看起来有点跟你想的不太一样,对不对?我也是这么想的,所以我再挖了挖。
重新从最大的样本来看,在 19,262 条记录当中:
-
明确拼音姓名:1,520 个
-
常见拼音姓氏:1,432 个
这里解释一下”常见拼音姓氏”的判定逻辑:比如原名叫王建国,英文名叫 Tony,写作 Tony Wang。这种情况下会被归入常见拼音姓氏,前提是拼法必须是大陆拼音的”WANG”;如果是”WONG”,则会被放进海外华人组别(即非拼音组别)。拼音相关的组别加起来共有 2,952 人,相对来说置信度比较高。这 2,952 人占全部简历的 15%,这个比例听起来可能更合理一些。
但说实话,名字是拼音,也有可能这个人是在美国出生长大的 ABC。说不定他还没有那个来华东师范学中文的美国白人更喜欢中国呢。
这里我想引用一个 2029 届哈佛大学本科生的统计数据(即 2025 年入学的 1675 个孩子)。
官方统计数据如下:
-
亚裔美国人:占 41%(这里的亚裔打包了东亚、东南亚和南亚印度,官方不对此进行拆分)
-
黑人:占 11.5%
-
西班牙裔:占 11%
-
未填报种族:8% 的学生选择不填报
-
白人:剩下的比例可以理解为基本都是白人
在这当中,第三方通常的估算方法是:在 41% 的亚裔人当中,东亚裔占三分之二,南亚裔占三分之一(这是一个外部估算,非官方内部数据,但可以作为一个相对的映照关系)。按照这个比例计算:东亚人种:占 27%(即 41% 的三分之二)然后南亚人种:占 14%(即 41% 的三分之一)
如果假设拼音名字的学生占 15% 的话,也就可以得知其他的东亚学生(包括港澳台、新加坡、日韩等)占另外的 12%,这听起来也是一个比较合理的数字。这个和你在美国常青藤大学读书时见到的人群分布,其实是非常统一的。哈佛大学的新生录取跟硅谷现在的人才分布是呈高度相关性,所以用这个数字做 sanity check。
另外在之前的部分当中有提到,在有提供语言标签的人里,会中文的人占整体样本的 20% 多。肯定包括这些拼音名字的 15%,也包括港澳台、东南亚的华裔,或者是美国的其他移民华裔,加起来可以凑整到 20% 多。不知道你有没有其他的方法去评估?欢迎在评论区给我留言。
有趣的发现?
-
这三家公司在地点、学校分布、前雇主(人才来源分布)、职能分布、语言分布,甚至中文的比例上,其实都高度相似。看起来太像了,非常同质化的竞争。那些表格如果不认真看小字,都觉得是同一家公司的。名字对换你也无法发现到底谁是对的,无法发现到底哪张图是真的 Anthropic,哪张图是真的 OpenAI。
-
Anthropic商业化职能比我想象的要高:商业拓展和销售人员其实挺多的。不过可以想象,作为一家做 to B 销售的公司,在 B 端发力也是情理之中的事。
-
在号称最核心的 AI 安全与对齐部门中,人数占比为 2.3%,据说是OpenAI的两倍。但我也不太清楚,安全与对齐部门 2.3% 的人员占比到底算多还是算少?够用吗?如果不够的话,多少才算够?
-
浙大真的好厉害呀!
-
DeepMind 是唯一一家牛津和剑桥的人排得上名的,因为另外两家的牛津、剑桥学生完全没有存在感。这主要是因为 DeepMind 原来是从伦敦起家的
-
Anthropic 的简历库里,有 44 个人的简历当中出现了 OpenAI,也就是说他们之前是从 OpenAI 跳槽去 Anthropic 的;而反向流动(从 Anthropic 跳去 OpenAI)的人只有 9 个。虽然因为数据点太少、置信度不高,但我感觉跳槽流动方向的比例应该是对的
-
我在看那 343 个中国背景的简历时,有非常多发现的。人生故事还挺有意思。我觉得有些人是非常值得上播客的,我先把他们的东西都进一步过一下,改天我要约他们的话,我再来找你!
遗憾的地方:
-
内部晋升轨迹无法统计:由于一些时间数据当时没有很好地记录下来,无法统计他们是什么时候入职、职位是否有过变化。
-
离职人员去向无法统计:目前只能统计在职人员,无法统计曾经在 OpenAI 待过但后来离开的人去了哪里。这其实是一个很有意思的信息,因为在 OpenAI 待过之后选择去创业或加入其他公司,肯定表达了他们对某种方向的认可,这可能会是更有投资回报参考价值的信息。(这个我还没想好如何操作才更有效,可能在技术方案上我得再思考一下。欢迎大家给我一些灵感!)
-
大学毕业年龄统计缺失:原本想统计所有人的大学毕业年龄,但在统计过程中时间数据没处理好,后续也不打算重新弄了。不过我猜想最终的结论大概也是这三家公司的人都挺年轻吧。
你有什么好的角度可以充分挖掘这些数据的价值?欢迎在评论区给我留言。我看了 2 万多份简历,脑子有点僵掉了,非常需要你帮忙一起帮我开个脑洞,谢谢!
如果你也在看这个方向,或者不同意上面的判断,欢迎写信到 [email protected]——不想写信也没关系,把邮箱留在下面就行。
新的对谈与研究发布时,直接送到你的邮箱。